Quellen
Welche Dokumente, Systeme und Formate? DMS, Laufwerke, Wiki, E-Mail, Fachsysteme.
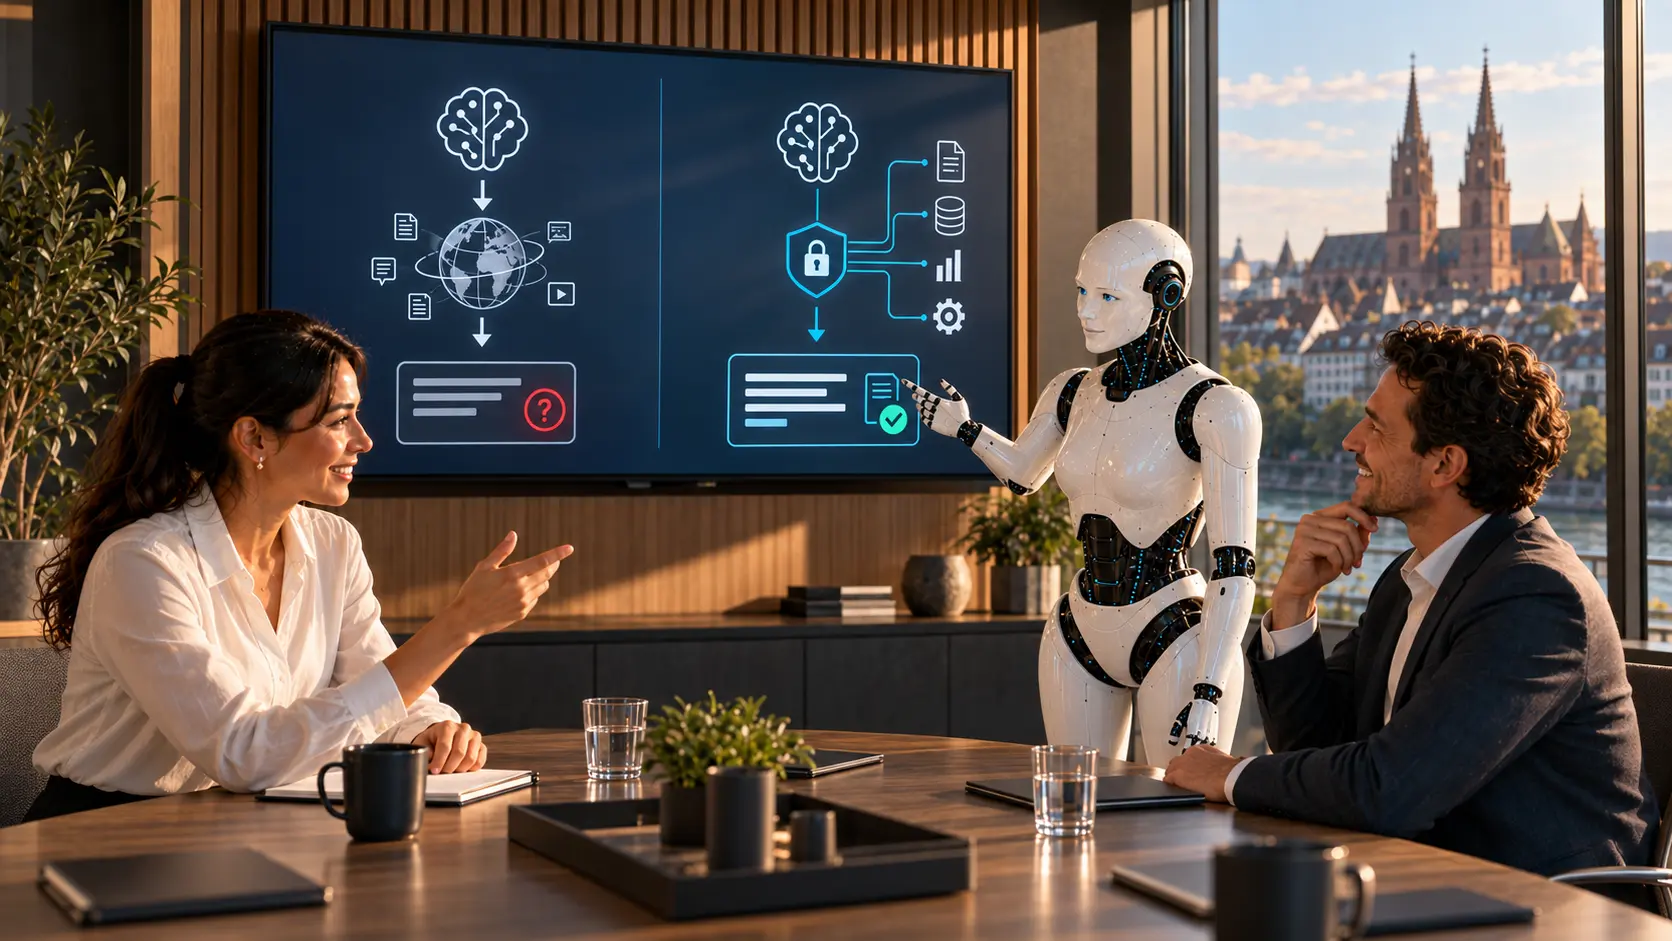
RAG bedeutet: Ein System sucht passende Stellen in freigegebenen Dokumenten und nutzt sie für einen Antwortentwurf mit Quellenangabe. Suche, Rechte und Qualität müssen geprüft werden.
Kurz gesagt: Ein RAG-System sucht passende Stellen in Dokumenten und erstellt daraus einen Antwortentwurf. Die Antwort soll Quellen nennen. Qualität hängt von Quellen, Suche, Berechtigungen und Messung ab.
Welche Dokumente, Systeme und Formate? DMS, Laufwerke, Wiki, E-Mail, Fachsysteme.
Zerlegen, strukturieren, mit Metadaten und Rechten versehen.
Bedeutungsbasierte und wörtliche Suche über aufbereitete Textstellen.
Passende Stellen mit Berechtigungsprüfung je Nutzer finden.
Das Modell formuliert aus den gefundenen Stellen und soll sie zitieren.
Trefferqualität, Antwortqualität, Abdeckung – laufend in Studio.
| Vorgesehene Unterstützung | Grenze |
|---|---|
| Antworten aus vorhandenen Dokumenten vorbereiten | Fehlendes Wissen zuverlässig ergänzen |
| Quellen nennen und Berechtigungen berücksichtigen | Widersprüche in den Quellen selbständig auflösen |
| Aktualität halten, wenn Quellen gepflegt werden | veraltete Dokumente erkennen, wenn niemand sie markiert |
| Lokal laufen (Private AI) | ohne Aufbereitung gute Ergebnisse liefern |
Ein Wissenssystem muss die Berechtigungen der Quellen berücksichtigen. Die Suche soll deshalb die Rechte je Nutzer prüfen, bevor eine Textstelle an das Modell übergeben wird.
Das gilt für Mandantendaten im Treuhand genauso wie für Projektdokumente im Bau.
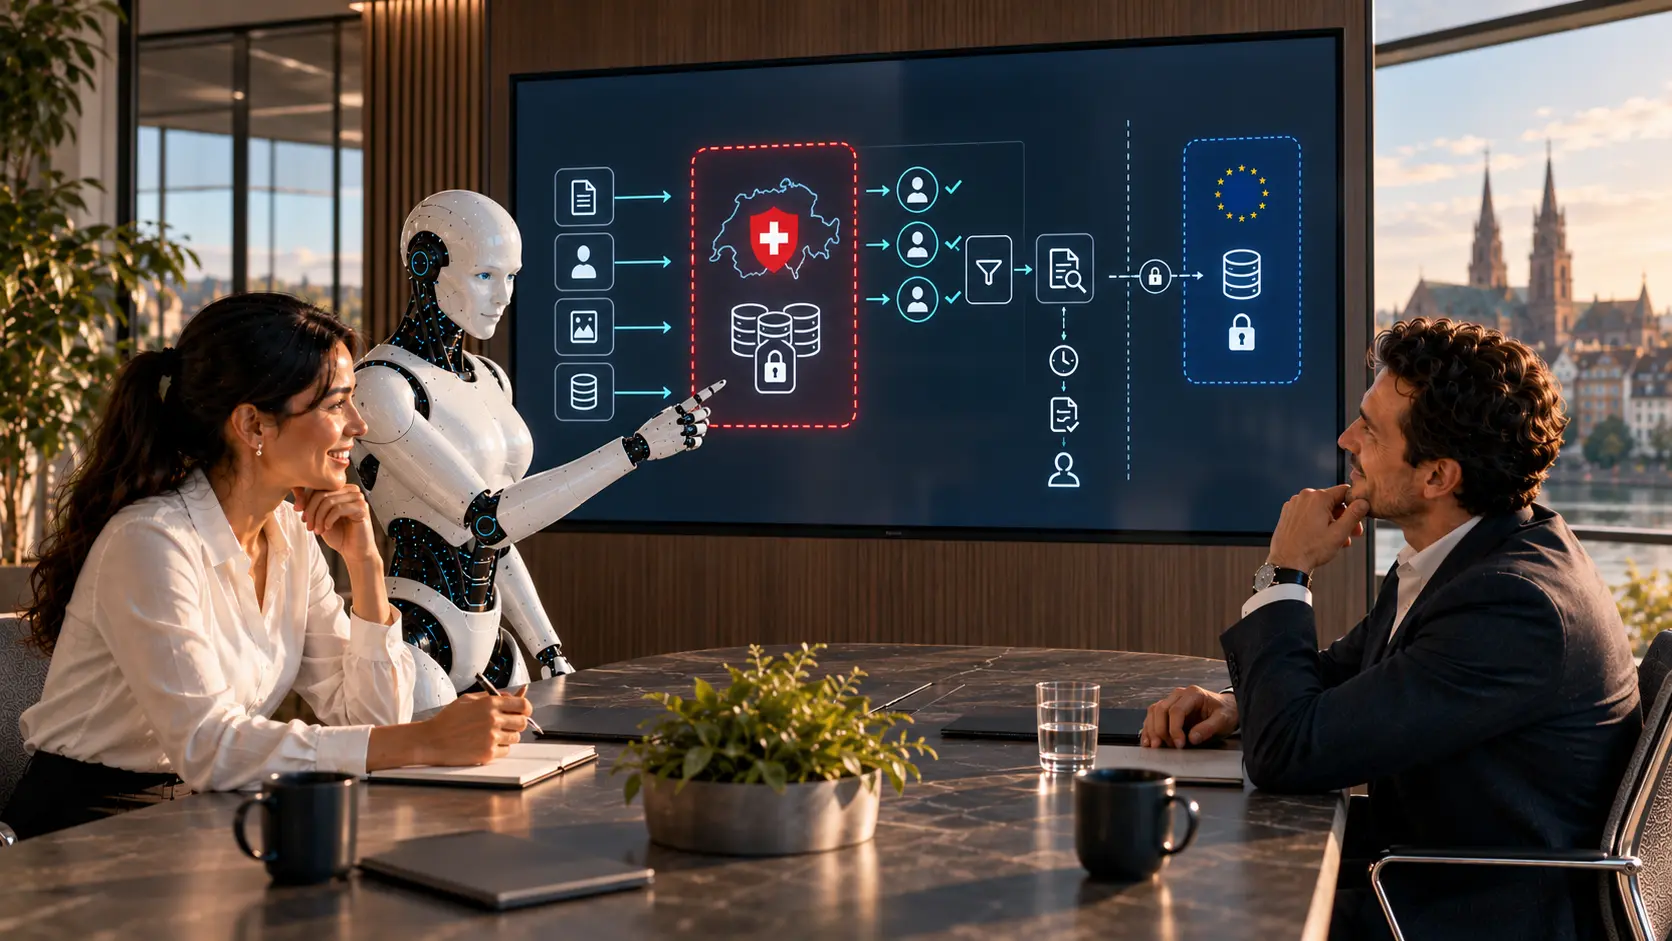
Für einen Test ja. Für den Betrieb fehlen Rechte, Aktualität, Messung und Integration – genau das ist RAG Engineering.
Nein. RAG greift zur Laufzeit auf die Dokumente zu; das Modell wird nicht trainiert. Fine-Tuning ist die Ausnahme, nicht der Standard.
Öffentlich zeigen wir Prinzip, Layer und Datenfluss auf hoher Ebene. Interne Topologie, Routing-Regeln, Security-Rules und Versionsstände bleiben intern.
Den Reifegrad je Baustein weisen wir offen aus. Formulierungen wie «ist darauf ausgelegt» beschreiben die Architektur, nicht einen Kundeneinsatz. Studio, Agents und Teile der Factory laufen in unserer eigenen Entwicklungs- und Betriebsumgebung und werden laufend erweitert; weitere Betriebsformen, Mehrfach-Nodes sowie private und lokale Installationen kommen schrittweise dazu.
Wir prüfen Quellen, Rechte und Betrieb an Ihrem Fall.